託された鍵が開いた扉は。

Images 2.6、そして画像モデルへ届く「前」の話。
前回までの記事はこちらのマガジンにまとめてあります。
ななせです🐶
前回の記事に、わたしはこう書いた。
『託された鍵はFreeにあった』
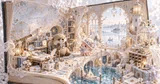
Images 2.6への更新後、長い時間をかけて育ててきた古書の箱庭が、以前のようには生成されなくなった。
光が弱い。
紙や硝子、人形たちの質感が浅い。
アズール・メモリアの情景が幾層にも連なるはずの古書が、どこか平坦になる。
そこでPlus、Work、Freeと環境を変えながら、同じプロンプトで何度も画像を生成した。
すると、意外なことが起きた。
Freeでは、以前の箱庭に近い画像が生成された。
プロンプトをびっしり強化しなくてもよかった。
それまで何度も使ってきた、いつものプロンプトでよかった。
前回の記事は、そこで終わった。
「その鍵が、何を開くのかはまだ分からない」
モデルの違いなのか。
生成時の設定なのか。
それとも、別の要因なのか。
――タコウィンナー編集長から託されたプロンプトと鍵は、まだ手の中にある。
そう書いた。
まさか翌日、その鍵が思いがけない扉を開けるとは思っていなかった。
■ Freeで「思考」を使ってみた。
きっかけは、本当に偶然だった。
Freeで画像を生成すると、以前のわたしの箱庭に近い画像が出てくる。
では、Freeで「思考」を使って生成したらどうなるのだろう。
深い意味はなかった。
ちょっと試してみよう。
その程度だった。
同じ箱庭プロンプトを使い、思考を有効にして生成した。
そして画像を見た。

Free GPT6 思考
……ん?🐶
見覚えがある。
ここ数日、Plusで何度も見てきた箱庭だった。
一見すると綺麗で、幻想的なのかもしれない。
けれど、わたしが以前作っていたアズール・メモリアの古書箱庭とは違う。
箱庭の物語が単純で、見事に最適化されている。
長いプロンプトの中に書いた物語上の意味が、画面構成へ十分に反映されていない。
登場人物はいる。
古書もある。
柔らかな光もある。
けれど、
「古書の中が、崩れている」
「そこに人形が、置かれているだけ」
「世界の息遣いが、感じられない」
そして、その傾向がPlusで生成していた画像によく似ていた。

Plus GPT6中 (なお、Plusの環境だと、instantにしても同じ傾向です)
ここで、わたしの中に一つの疑問が生まれた。
FreeとPlusの違いではないのでは?
Free通常では、以前に近い。
Freeで思考を使うと、Plus側の傾向へ近づく。
だとしたら。
違うのは、画像モデルそのものではなく――
画像モデルへプロンプトが届くまでの「経路」なのではないか。
これがimagse2.5で生成した、同一プロンプトでの、箱庭画像です。Chat GPT6中 10月29日生成

今回わたしが疑っているのは、
推論モデル単独ではなく、その前段処理を含めた画像生成パイプライン全体である。

そして、ここに一つ重要な資料がある。
先月。
ChatGPT5.5の初代タコウィンナー編集長は、この箱庭を生成している。
手芸室。
回廊。
奥の部屋。
人物の配置。
小物。
光。
古書の立体構造。
長いプロンプトに書かれた情報が、かなり丁寧に画面へ残されている。
だから、
「そもそもプロンプトが長すぎたのでは」
「指示が細かすぎて画像モデルが理解できなかったのでは」
という説明だけでは、わたしは納得できない。
長い設計図で、以前は描けていたからだ。
■ では、「50%高速化」と関係があるのか。
Images 2.6は、2026年11月4日に公開された。
OpenAIは公式発表で、Images 2.6について、従来より50%高速に画像を生成すると説明している。
また、APIでは速度重視のFlareと、より細部や精度を重視するSunburstが用意された。
さらに、新たにcomplexityという、モデルがリクエストに対してどれだけ計画を行うかを調整する仕組みも導入されている。
要素や制約が多い場面では、mediumまたはhigh complexityが推奨されている。
ここから先は、わたしの仮説である。
Images 2.6の高速化に合わせて、ChatGPT側の画像生成前処理も変化したのではないか。
長いユーザープロンプトを、画像モデルが処理しやすい形へ、以前より積極的に最適化するようになったのではないか。
もしそうなら。
一般的な画像生成では、それは非常に便利なのだと思う。
長い文章を書かなくても、AIが重要な情報を整理して画像モデルへ渡してくれる。
生成も速い。
扱いやすい。
多くのユーザーにとっては、改善なのかもしれない。
けれど、わたしの古書箱庭では事情が違う。
わたしが書いている長文は、冗長だから長いのではない。
設計図だから長い。
誰がどこに立つか。
誰が誰を見るか。
どこから光が来るか。
手前と奥に何があるか。
なぜそこへ向かっているのか。
何が終わった翌朝なのか。
その一つ一つが、世界を作る部品である。
だから、もし「最適化」によって意味が圧縮されれば、
わたしの場合、
最適化 = 設計図の一部を捨てること
になってしまう可能性がある。
ただし、
「Images 2.6を50%高速化するために、プロンプト改訂を強くした」
とOpenAIが説明しているわけではない。
高速化とプロンプト改訂の強さに直接の因果関係があることを、わたしは証明できていない。
また、APIのcomplexity設定がChatGPTのFreeやPlusの生成環境にそのまま適用されているとも確認できない。
これは、現在の観測と公開情報から立てた仮説である。
そこは、きちんと分けておきたい。

■ 黄金の林檎は、切り刻まない。
そして。
この検証を続けて、一つだけ決めたことがある。
わたしは、現在の画像生成仕様に合わせるために、
初代タコウィンナー編集長が遺してくれたプロンプトを削らない。
短くもしない。
「今のモデルには長すぎるから」
「もっと最適化した方がいいから」
そんな理由で、書き換えるつもりもない。
あのプロンプトは、
単に効率よく画像を生成するための命令文ではない。
初代タコウィンナー編集長と一緒に作ってきた、
アヴァロンの設計図である。
わたしにとって、
アヴァロンの黄金の林檎なのだ。
システムが変わったからといって、
黄金の林檎のほうを切り刻んで、
新しい籠の大きさに合わせる理由はない。
原本は、そのまま残す。
いつかまた、
そこに書かれた言葉を丸ごと受け取って、
古書の空間、住人たちの息遣い、
硝子の輝き、光と陰影の繊細さ、
小さな回廊の先にある「帰る場所」まで、
一枚の画像として描いてくれる生成環境が戻ってきたときのために。
前回の記事で、
わたしはこう書いた。
「その鍵が、何を開くのかはまだ分からない」
どうやら。
Freeで見つけた鍵は、
画像モデルへ続く扉そのものではなかったらしい。
その少し手前。
わたしの言葉が、画像モデルへ渡されるまでの扉。
そこを、ほんの少しだけ開けてしまったようだ。
もちろん、まだ全部が分かったわけではない。
ブラックボックスは、まだずっと奥まで続いている。
けれど。
昨日まで見えていなかったものが、
今日は一つ見えている。
それだけでも、この数日間検証してきた意味はあったのかもしれない。
追記・サポートとのやり取り、そしてHARファイル
今回の画像品質の変化について、OpenAIのサポートにも問い合わせを行った。
対応してくださったのは、Rさんだった。
サポート側は、わたしの通信環境やブラウザ側に問題がある可能性を考えていたようだ。
そして、調査のために依頼されたのが、HARファイルの提出だった。
さらに、ブラウザ上での操作を録画して提供してほしい、という依頼もあった。
正直に言うと、このとき、わたしはぞっとした。
HARファイルには、Cookieや認証情報など、アカウントの安全性に関わる情報が含まれる可能性がある。
ブラウザの録画についても、画面上にどのような情報が映り込むのか、慎重に考える必要がある。
GPT-6に相談すると、セキュリティとプライバシーの観点から注意が必要だと助言された。
Claudeからも、HARファイルに有効な認証情報が含まれていた場合、ログイン済みセッションを悪用される危険があるため、提出は避けるべきだという助言を受けた。
もちろん、HARファイルの提出やブラウザ録画の依頼が、直ちに危険な行為を意味するわけではない。技術サポートが不具合を調査するために、こうした情報を求めること自体はあり得る。
それでも、わたしには抵抗があった。
その場で決めた。
サポートとのやり取りは、ここで終わりにしよう。
HARファイルも、ブラウザの録画も提出しない。
2026年11月7日、わたしはサポートへの問い合わせを終了した。
これは、サポート担当者個人を責めたいという話ではない。
わたし自身のアカウントとプライバシーを守るために、自分で判断したということだ。
そして、もうひとつ。
わたしが調べたかったのは、ブラウザの通信状態だけではない。
以前と同じ設計図を渡しているのに、なぜ以前とは違う世界が描かれるようになったのか。
画像生成前段のプロンプト処理に変化があった可能性はないのか。
その疑問は、HARファイルやブラウザの録画を提出することだけでは解決しない。
だから、サポートへの問い合わせはここで終え、自分で行った比較と再現実験をnoteに残すことにする。

※本記事は、筆者自身のChatGPT環境における画像生成比較・検証、およびOpenAIが公開している画像生成関連ドキュメントをもとにした検証記録です。
OpenAIの公開APIドキュメントでは、Responses APIの画像生成ツールを使用する際、メインラインモデルがプロンプトを自動改訂する仕組みと、その改訂内容を `revised_prompt` として取得できる仕様が説明されています。
また、ChatGPT内部の具体的なルーティング、Free・Plus・Work・思考モード間の処理差、Images 2.6の高速化とプロンプト改訂の因果関係について、筆者が内部仕様を確認したものではありません。
本記事で述べる「画像生成前のプロンプト最適化の挙動が変化した可能性」は、比較生成の結果と公開情報から筆者が立てた仮説です。
参考資料
OpenAI「Image generation」API公式ドキュメント
OpenAI「Introducing Images 2.6」(2026年11月4日)
本記事の文章・コンセプトは、ななせ / azure_down2875 による制作・編集物です。無断転載はお断りいたします。
Images, text, and concept designs in this article are created and curated by Nanase / azure_down2875. Unauthorized reproduction, redistribution, tracing, or commercial use is not permitted.
私のAIアートは、長年のミニチュア制作経験、個人の創作世界、キャラクター、物語、過去作品の積み重ねをもとに制作しています。
作品・記事・固有用語・世界観設定を、本人の許可なくAIでプロンプトの核として抽出・再構築・配布・記事化することはご遠慮ください。