
Google 在 Cloud Next'26 詳解第 8 代 TPU 架構,推出 TPU 8t 與 TPU 8i 雙晶片策略,分別專攻模型訓練與推論,搭配全新 Virgo Network 網路技術,性價比相比前代大幅提升。
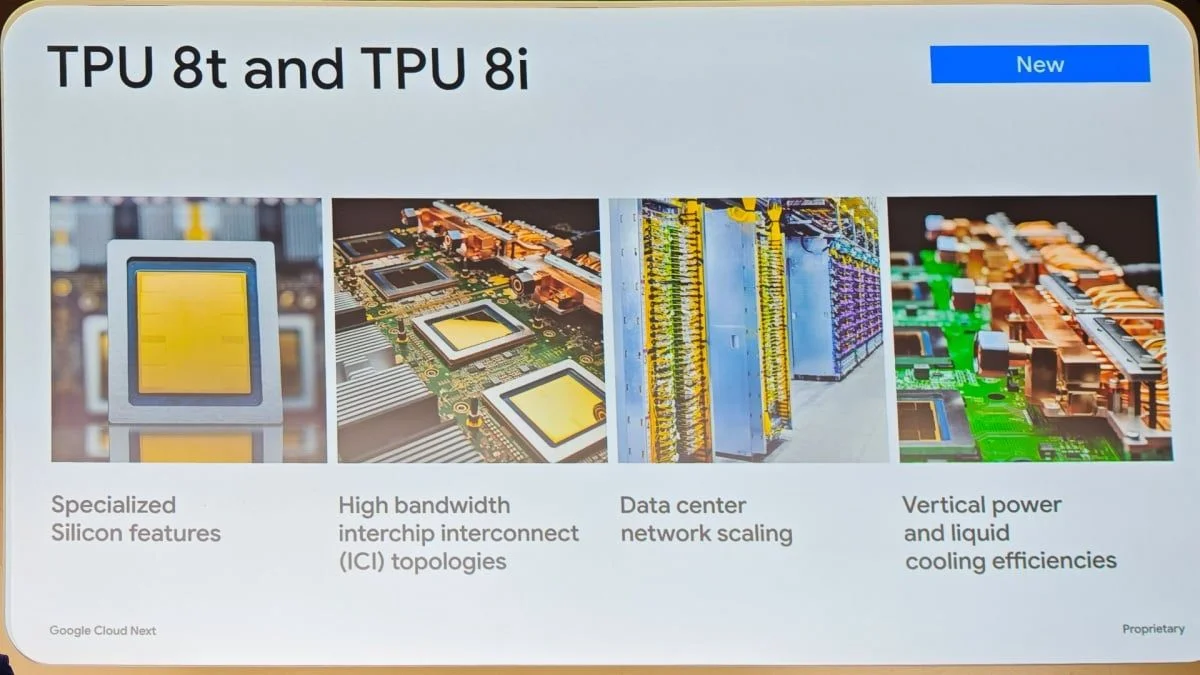
在今年於拉斯維加斯舉辦的Google Cloud Next’26期間,除了大會主題演講時的重點說明外,Google在分場活動的議程中,更進一步由基礎架構團隊深入剖析最新TPU發展藍圖。呼應此次議程主軸「如何為前沿AI設計TPU架構」,Google更詳解此次更新的第8代TPU「們」 (TPU 8t與TPU 8i)的硬體架構細節,更展示包含AI團隊Decart在前沿世界模型 (frontier world models)上的實際應用成效。
從整體架構來看,Google已經意識到單一晶片架構難以同時滿足動輒兆級參數的巨型模型訓練,以及要求極低延遲的推論服務,因此在第8代TPU走向更明確的雙架構分流策略,並且在網路互連技術上進行全面換血。
延續與突破:Ironwood架構、3D Torus與Virgo Network
在此次技術解析中,Google強調第8代TPU延續在先前世代中打下基礎的Ironwood架構,並且進一步強化RDMA (遠端直接記憶體存取)效能,搭配升級版的TPUDirect Storage技術,讓資料在晶片與儲存叢集之間搬運的傳輸延遲降到最低,對於需要頻繁讀取龐大資料集的前沿AI模型而言,將能大幅減少運算單元「等待資料」的閒置時間。

此外,TPU 8t更在協同運算核心SparseCore搭載大型語言模型 (LLM)解碼引擎,使其算術強度提升高達30倍,藉此讓諸如DLRM DCN v2模型運算效率可提升5倍。而在TPU 8i部分,則是將SparseCore作為集體加速引擎使用,搭配整合384MB SRAM靜態隨機存取記憶體,作為KV快取使用,進而提升大型AI模型推論時的短期記憶,藉此降低計算重複資料時的算力與記憶體容量損耗,同時也能提高推論效率。


而在算力擴展 (Scaling)的設計上,Google採取「垂直與橫向」雙管齊下的策略:
• 垂直提高算力 (Scale-Up):在單一Pod內部,Google依然採用成熟且高效率的3D Torus網路拓樸架構,並且透過頻寬再次翻倍的ICI (Inter-Core Interconnect)互連技術,讓相鄰的TPU晶片能以超高頻寬、極低延遲形式進行資料快速交換,使得單一叢集內的所有TPU能宛如一顆巨型晶片運作,相當適合處理高度耦合的運算任務。

• 橫向擴展規模 (Scale-Out):為了突破單一Pod的物理限制,透過串聯方式建構足以訓練次世代前沿AI模型的資料中心級算力,Google詳細說明全新的Virgo Network技術。Virgo Network專為跨叢集,甚至是跨資料中心的龐大算力池所設計,確保在以萬顆為單位的TPU進行分散式運算時,依然能維持穩定、高度的網路吞吐量與容錯率。

 ▲除了藉由TPU 8t進行預先訓練,在推論過程仍會持續以輸出結果再次進行訓練,藉此推動正向的學習成長
雙架構並進:TPU 8t專攻極致訓練,TPU 8i最佳化推論成本
Google過去的TPU設計多半試圖在訓練 (Training)與推論 (Inference)之間取得平衡 (例如過往推出的v4或Trillium,乃至於前一代Ironwood),但隨著生成式AI產業的成熟,工作負載已經出現明顯分化,因使勢必要將「訓練」與「推論」徹底拆分,藉此在「訓練」時能以更大效率進行,而在「推論」時則能實現更大成本效益,因此不像過往只是藉由相同TPU,搭配不同記憶體等架構設定,同時統包「訓練」與「推論」工作。
• TPU 8t (訓練):字尾的「t」代表訓練。這款架構為了應對巨型語言模型與多模態模型的預訓練,搭載最大容量的HBM高頻寬記憶體,並最大化矩陣乘法單元 (MXU)的峰值算力。其設計哲學是不計代價地追求運算密度與記憶體頻寬,藉此縮短前沿模型的訓練週期。


• TPU 8i (推論):字尾的「i」代表推論。這款架構捨棄部分訓練專用的複雜指令集,將晶片面積投資在更大的SRAM靜態隨機存取記憶體快取與更傳輸更高速的I/O吞吐上,目的是為了在模型佈署階段,提供最低的首字延遲 (TTFT)與最高的資料吞吐量,其中甚至採用HBM3e高頻寬記憶體 (相比TPU 8t採用的HBM3高頻寬記憶體提供更高資料傳輸頻寬),同時大幅壓低每筆API呼叫的營運成本。


軟體生態的護城河:PyTorch on TPU的優勢
當然,擁有再強的硬體,若沒有開發者生態支持也是枉然。面對NVIDIA CUDA築起的生態高牆,Google此次特別花費篇幅分析接下來將登場的PyTorch on TPU設計優勢。

藉由持續最佳化XLA (Accelerated Linear Algebra)編譯器,Google已經讓PyTorch開發者能以「零程式碼修改」或「極少修改」的方式,將原本在GPU上運行的模型無縫轉移到TPU運算叢集上,減少不同運算移轉時的轉譯成本。
PyTorch/XLA現在能自動將動態圖轉譯為TPU可高效執行的靜態圖,加上支援自動混合精度訓練 (AMP)與完全分片資料平行 (FSDP)等前瞻技術,讓新創團隊能輕易將現有的PyTorch專案搬遷至TPU 8t進行大規模訓練。
回顧TPU發展史
回顧Google TPU的發展歷程,可以看出其架構演進幾乎就是一部近代AI發展史的縮影:
• TPU v1 (2015):專注推論,為AlphaGo與內部搜尋提供加速。
• TPU v2/v3 (2017-2018):導入浮點運算與HBM高頻寬記憶體設計,正式跨足模型訓練,並且提出Pod叢集概念。
• TPU v4 (2021):引入光交換機 (Optical Circuit Switches)與3D Torus架構,確立百萬兆級 (Exaflops)算力規模里程碑。
• TPU v5e / v5p (2023):首度嘗試將產品線劃分為主打性價比 (v5e)與極致效能 (v5p),為未來的分軌發展埋下伏筆,但此階段仍是以不同記憶體配製作區隔,本質上仍是相同TPU設計。
• TPU v6「Trillium」 (2024):全面擁抱生成式AI,大幅提升能源效率與記憶體頻寬,本身也是同時具備「訓練」與「推論」能力,並且成為後續「Ironwood」的設計基礎。
• TPU v8 8t / 8i (2026):正式確立訓練與推論的雙架構 (t/i)策略,並且透過 Virgo Network將算力橫向擴展推向全新境界。


Decart前沿世界模型應用
在此次議程的下半場,大會也特別邀請了知名AI團隊Decart分享其在第8代TPU上運行前沿世界模型的成果。
Decart指出,世界模型 (World Models)需要處理極度複雜的物理法則與時間序列生成,這對於記憶體頻寬與互連延遲的要求極為嚴苛。藉由TPU 8t的ICI互連技術與 TPUDirect Storage資料處理方式,Decart成功將資料載入的瓶頸降至最低,並且在TPU 8i上實現近乎即時的互動式推論體驗,充分印證Google此次雙架構設計與基礎網路技術升級的實戰價值。
而之所以透過Decart的前沿世界模型運行成果闡述第8代TPU性能表現,顯然是針對先前「Google的TPU就難以執行像Decart這種需要即時渲染處理的工作負載」等批評所作回應,強調目前的TPU運作已經能藉由PyTorch on TPU設計,完整對應藉由PyTorch打造的運算專案,更代表Google將持續與諸多開源運算合作最佳化應用。