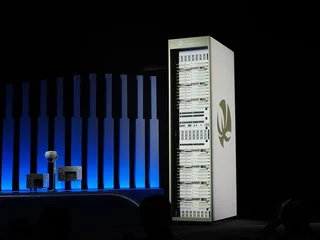

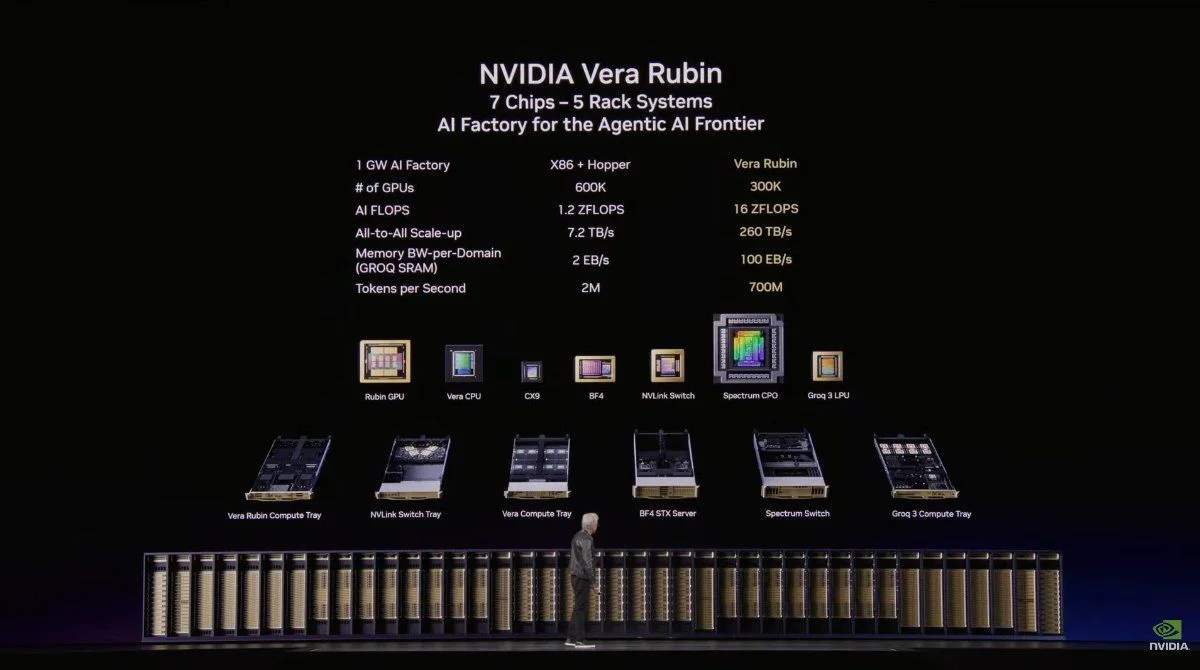
NVDIA全新AI系統Vera Rubin預計在2026年末陸續推出,NVIDIA也搶先公布NVIDIA Vera Rubin NVL72於MLPerf Inference v6.1的表現,即便是非常初期的結果,也僅進行最多4座機架連接的測試,但在相同規模的表現仍舊領先群雄,單一機架相較GB300 NVL72的傳輸量甚至高達3.7倍,而4座系統擴展甚至達99%的線性效能擴展。
再次自我超越的效能領先
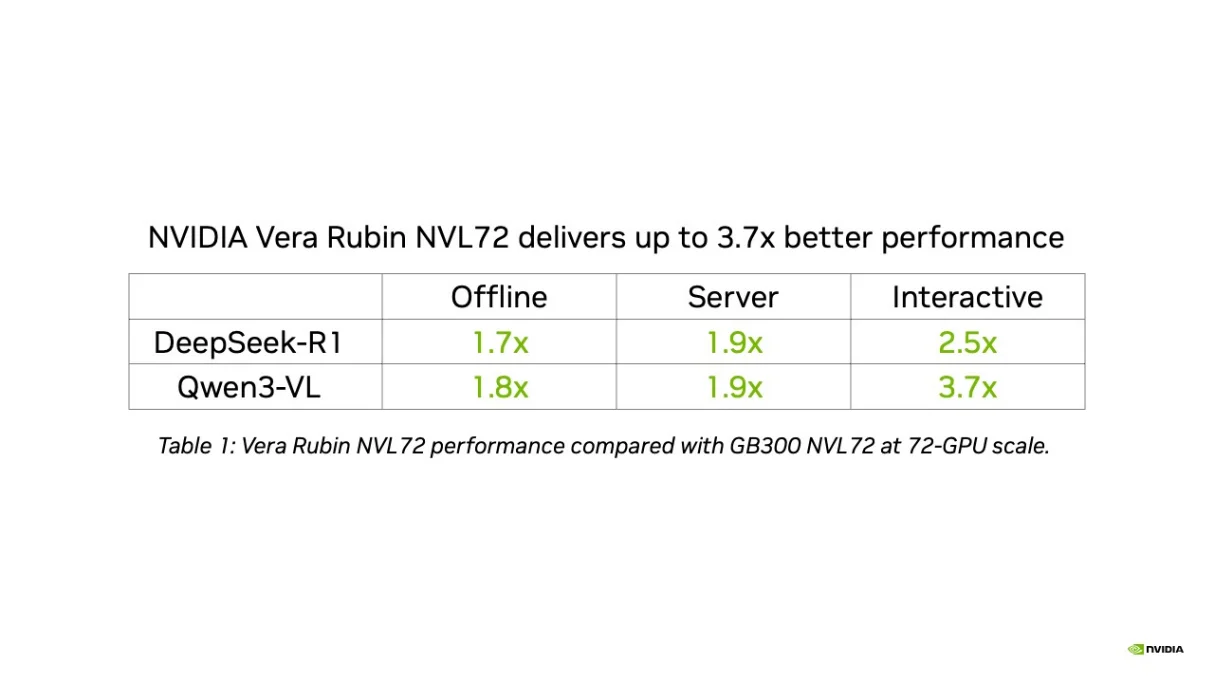
NVIDIA Vera Rubin NVL72在MLPerf Inference v6.1首次亮相就取得出色的成績,在DeepSeek-R1與Qwen3-VL兩項指標性基準測試提交的結果相當亮眼;於離線、伺服器與互動情境,NVIDIA Vera Rubin NVL72採用vLLM與NVIDIA Dynnamo開源推論框架,於Qwen3-VL對比GB300 NVL72高出3.7倍,而在DeepSeek-R1,以TensorRT-LLM函式庫的傳輸量高出2.5倍。
這些初步成績顯示NVIDIA Vera Rubin NVL72產生的詞元數量、服務的使用者數量、創造的營收均遠勝過現行相當優越的GB300 NVL72,同時每詞元成本也更低;這樣的佳績來自Vera Rubin深度軟硬整合的全端協同設計,由Vera Rubin增強的Tensor Core及Transformer Engine可加速推論的預填充及解碼階段,同時支援NVFP4精度,可降低模型權重、注意力與KV快取的記憶體占用量。
在大量創新與深度整合下,Vera Rubin透過分離式服務將預填充與解碼分開,並搭配大規模專家平行化,在這兩項高度複雜的AI模型的混合專家層達到最高效率;而且這只是個開始,NVIDIA後續仍會持續進行軟體最佳化,並在Vera Rubin生命週期內持續提升其表現;即便是GB300 NVL72,於MLPerf Inference v6.1的表現亦較MLPerf Inference v6.0提高最多1.6倍。
近乎無損的線性效能擴展
然而,在如今的AI基礎設施架構,僅看單一機架效能並不能代表一切,在經過擴展後的效能是否能趨近無損才是關鍵,倘若大幅增加GPU但提昇的性能僅提升個位數,就完全不合乎成本效益,架構與軟體之間都需要同步擴展;Vera Rubin借助高頻寬、低延遲的垂直擴展互連、機架之間的高頻寬網路與跨節點的高效協調請求,實現近乎線性的效能提升。
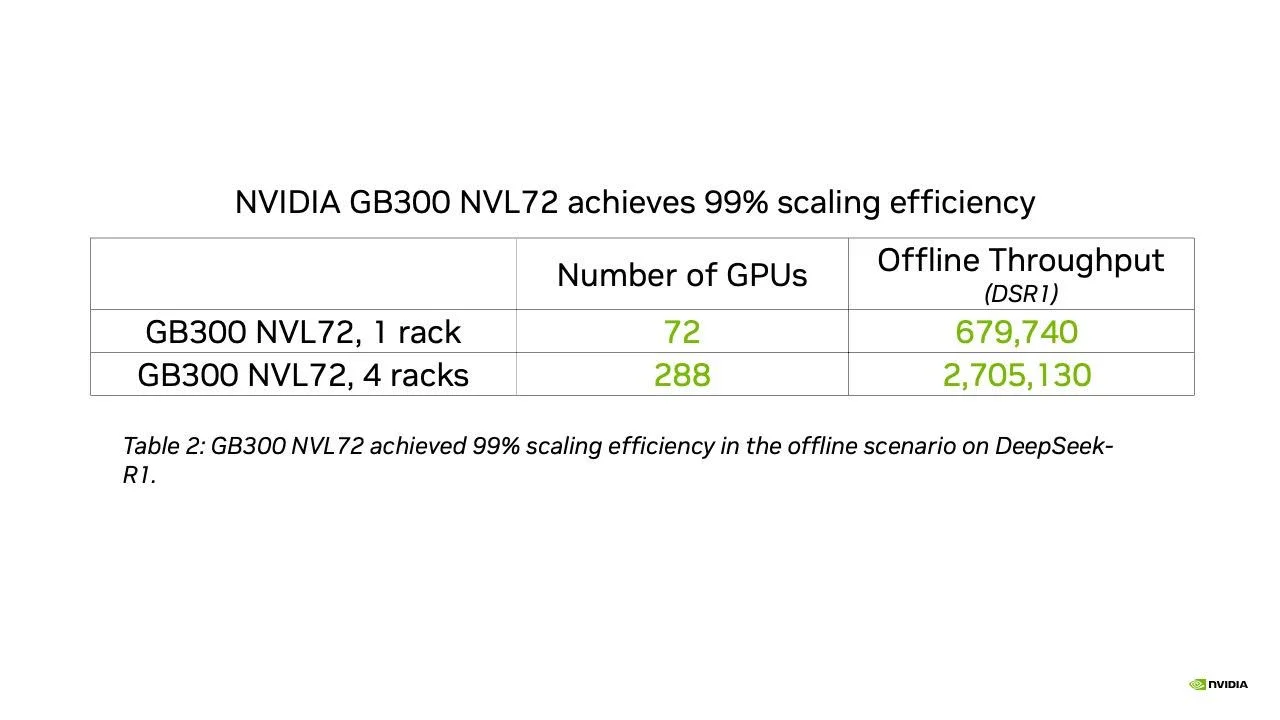
NVIDIA以單一機架與4機架擴展執行DeeSeek-R1作為對照組,在GPU自72個提升至288個規模,於離線情境達到99%的近無損擴展效率;此外在WAN 2.2文字轉影片基準也展現多機架的規模效率優勢,相對單一節點提升9倍輸送量、延遲降低7.5倍,每秒可產生0.65部720p影片、每部影片生成時間僅5.7秒。
GB300 NVL72效能仍藉軟體升級提升
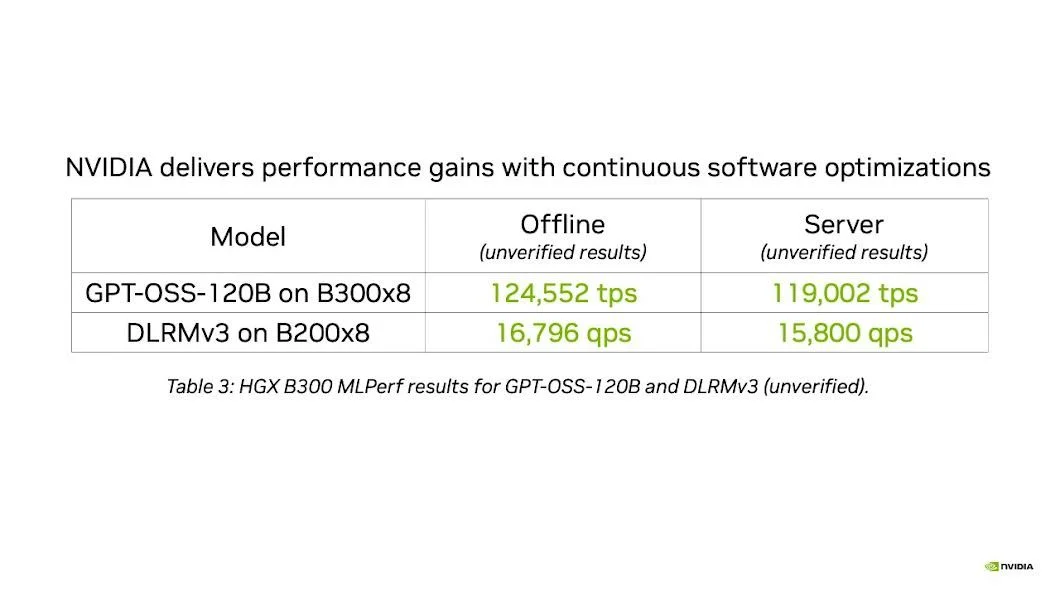
對於NVIDIA,持續投入軟體提升效能與增加新功能是相當重要的,GB300 NVL72於MLPerf Inference v6.1遞交的成績相對相同Qwen3-VL測試項在前一次MLPerf Inference v6.0的表現提升達1.6倍,主要是在兩次測試之間引進較低精度的KV快取、更多核心融合、效能更高的核心,以及採用vLLM與NVIDIA Dynamo的分離式服務。