
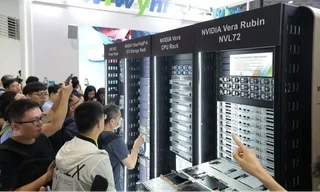
輝達新一代Rubin平台憑藉35倍推論效能,旨在觸發傑文斯悖論,以成本降低解鎖龐大新需求。搭配自研Vera CPU掌握完整架構主導權,將鞏固其生態系,並深化與台積電在先進製程及封裝的合作。
Vera Rubin預計在2026年下半年開始出貨,Nvidia公布了一個讓人眼睛一亮的規格:Rubin系列能提供比Blackwell高出35倍的推論吞吐量。法說會的原話是這樣說的:
By integrating seven purpose-built chips across five accelerated racks, Vera Rubin will deliver up to 35x higher inference throughput and up to 10x greater AI factory revenue compared with Blackwell.
這裡同時出現了兩個數字:35倍推論吞吐量,和10倍AI工廠營收。它其實更直接的意思是,每一套Rubin系統為客戶產出的商業價值,是Blackwell的十倍。這對台灣ODM廠商(廣達、緯穎)的意義是:Rubin系統的單機售價(ASP)遠高於Blackwell,即便出貨量不變,帳面營收也會跳升一個量級。
這篇要談的是主角的背後:Rubin的35倍推論吞吐量到底代表什麼,以及Nvidia為什麼要自己做CPU。本文從推論算力的角度,拆解這份財報裡最讓人印象深刻的數字:35倍。
35倍的推論吞吐量:解封被成本壓抑的需求場景
先把35倍放在GPU從晶片到機櫃的演進脈絡裡。
從H100到Blackwell,Nvidia大約花了兩年,推論吞吐量的提升幅度大約在五到七倍之間。從Blackwell到Rubin號稱35倍,這個跳幅之所以這麼大,部分原因在於Rubin是第一個從設計階段就明確針對推論工作負載優化的世代:七顆專用晶片、五個加速機架,是整個計算堆疊從底層重新架構的結果,不是同一個設計的效能延伸。
我在第三篇《當AI不再等於輝達GPU(三):四大CSP四種變現路徑,面臨一個共同的邏輯瓶頸》論述推論成本時,用「斜率」來描述改善速度:斜率越陡,CSP(雲端服務供應商)的單位經濟學改善得越快,AI服務的商業模式就越早能站穩。Rubin的35倍如果在量產後得到驗證,就是這條斜率的一次急速俯衝。
然而,事實上,這條斜率已經在俯衝了。黃仁勳在法說會提到,透過軟硬體整合的「全棧優化(Full Stack Innovations)」,在極短的時間內(6個月)不僅大幅提升了推論吞吐量(2.7倍),更顯著降低了客戶的使用成本(降低60%),比摩爾定律還快。Rubin的35倍,將會是在這個基礎上再疊加一次。


- 台積電
- AI
- NVIDIA
- Vera Rubin
- GPU
- 輝達
- 黃仁勳
- Rubin
- AI Agent
- 傑文斯悖論
- AI推論
- Agentic AI
- Vera CPU
- AI工廠
- 架構主導權
- Jevons Paradox


